


Studien – kritisch hinterfragt
Statistische Signifikanz verstehen: Wie Studien Ergebnisse verzerren können
Was bedeutet statistische Signifikanz wirklich? An einem einfachen Beispiel zeige ich, wie dieselben Studiendaten völlig unterschiedlich dargestellt werden können.
„Eine Studie zeigt …“
Wenn ich diesen Satz lese, werde ich mittlerweile erst einmal vorsichtig.
Nicht, weil ich Studien nicht traue. Im Gegenteil. Ich versuche selber, möglichst evidenzbasiert zu arbeiten.
Aber je mehr man sich damit beschäftigt, desto mehr merkt man: Zwischen den Rohdaten einer Studie und der Schlagzeile, die am Ende daraus wird, kann ziemlich viel passieren.
Das sieht man gerade in der Ernährungswissenschaft immer wieder. Viele langfristige Fragen lassen sich schlicht nicht perfekt randomisiert untersuchen.
Wenn ich wissen möchte, ob eine bestimmte Ernährung nach 30 Jahren das Krebsrisiko erhöht, kann ich Menschen schlecht für 30 Jahre zufällig zuteilen, ihre Kalorien exakt kontrollieren, Bewegung, Alkohol, Rauchen, Gewicht und Lebensstil identisch halten und dann schauen, was passiert.
Also arbeitet man häufig mit Beobachtungsdaten.
Das ist sinnvoll und wichtig.
Aber dann kommt Statistik ins Spiel.
Welche Faktoren rechne ich heraus? Welche Gruppen bilde ich? Welchen Endpunkt betrachte ich? Und welche dieser Ergebnisse landet später in der Überschrift?
Und genau da wird es interessant.
Machen wir eine eigene kleine Studie
Angenommen, ich möchte ein neues Supplement verkaufen.
Ich investiere in eine Studie mit 20 Teilnehmern. Nach drei Monaten messen wir einen bestimmten Blutwert.
1,0 bedeutet: keine Veränderung.
Über 1,0 bedeutet Verbesserung, unter 1,0 Verschlechterung.
Die Ergebnisse:
3 Personen: +60 %
1 Person: +10 %
11 Personen: 0 %
5 Personen: −10 %
Also ganz einfach:
4 verbessern sich. 11 passiert nichts. 5 verschlechtern sich.
Wenn ich nur diese Grafik sehe, ist mein neues Supplement erst einmal nicht wahnsinnig überzeugend.
20 Prozent verbessern sich.
25 Prozent verschlechtern sich.
55 Prozent haben überhaupt keine Veränderung.
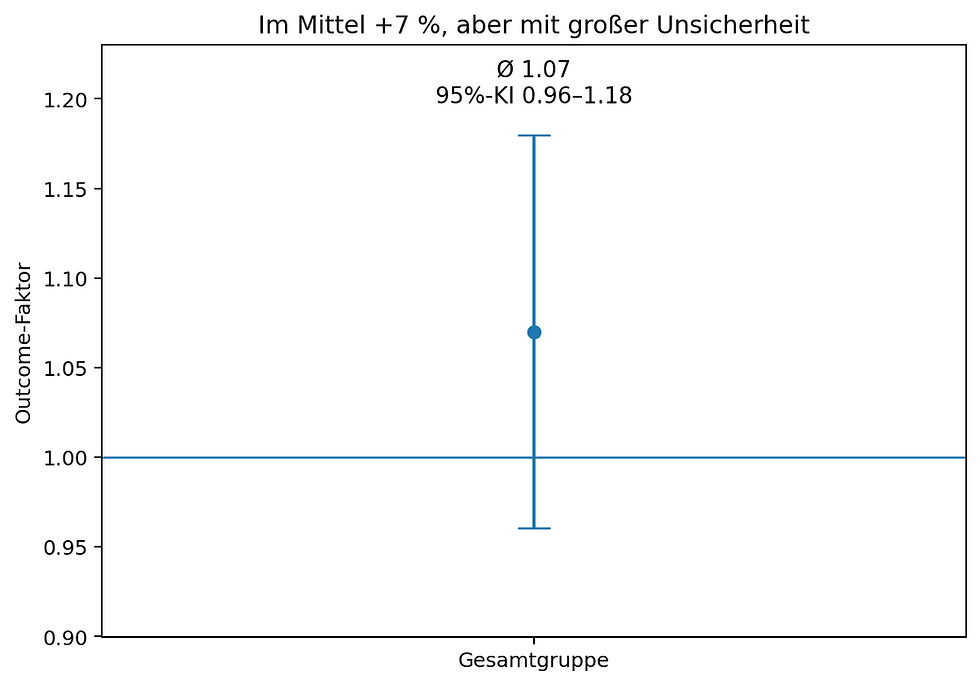
Aber jetzt bilde ich den Durchschnitt.

Und plötzlich sieht es besser aus.
Im Durchschnitt: plus 7 Prozent
Weil drei Teilnehmer sehr stark reagieren, ziehen sie den Mittelwert deutlich nach oben.
Im Durchschnitt liegt die Verbesserung bei 7 Prozent.
Das stimmt.
Aber die Verteilung sieht eben so aus:
Und genau das ist für mich ein schönes Beispiel dafür, warum ein Mittelwert alleine manchmal erstaunlich wenig erzählt.
16 von 20 Teilnehmern haben sich überhaupt nicht verbessert.
Trotzdem ist der Durchschnitt positiv.
Jetzt machen wir noch einen statistischen Test.
Das Ergebnis ist nicht statistisch signifikant. Das 95-%-Konfidenzintervall reicht ungefähr von einem leicht negativen bis zu einem deutlich positiven Effekt.
Mit diesen 20 Menschen wissen wir also schlicht nicht besonders genau, wie groß der tatsächliche durchschnittliche Effekt ist.
So weit, so unspektakulär.
Nur habe ich jetzt ein Problem.
Die Studie war teuer.
Mein Produkt steht vielleicht schon im Lager.
Und Marketing hätte gerne eine schöne Aussage.

Also stellen wir einfach eine andere Frage
Statt:
„Wie viele Menschen haben sich verbessert?“
frage ich:
„Wie viele Menschen haben sich zumindest nicht verschlechtert?“
Jetzt passiert etwas Spannendes.
Vier haben sich verbessert.
Elf sind gleich geblieben.
Macht zusammen:
15 von 20.
Oder:
75 Prozent.
Aus
20 % verbessert, 55 % keine Wirkung, 25 % verschlechtert
kann ich jetzt machen:
75 % der Teilnehmer blieben stabil oder verbesserten sich.
Beides ist mathematisch richtig.
Es erzeugt nur eine völlig andere Wahrnehmung.
Ich kann noch weitergehen.
Ich nehme nur die besten 25 Prozent der Teilnehmer.
Deren durchschnittliche Verbesserung beträgt 38 Prozent.
Also:
„Das Top-Quartil zeigte eine durchschnittliche Verbesserung von 38 Prozent.“
Stimmt ebenfalls.
Oder ich nehme nur die vier Personen, die positiv reagiert haben.
Dann beträgt die durchschnittliche Verbesserung bei den „Respondern“ sogar 47,5 Prozent.
Auch richtig.
Nur habe ich diese Menschen ja gerade deshalb als Responder bezeichnet, weil sie positiv reagiert haben.
Und plötzlich wird es sogar „signifikant“
Noch interessanter wird es, wenn ich nicht mehr frage, ob sich der durchschnittliche Wert verbessert hat, sondern ob mehr als 50 Prozent der Teilnehmer zumindest stabil geblieben sind.
15 von 20 erfüllen dieses Kriterium.
Dann kann ich mit einem entsprechenden statistischen Test plötzlich einen p-Wert unter 0,05 erhalten.
Und jetzt könnte irgendwo stehen:
„75 % der Teilnehmer erreichten Stabilisierung oder Verbesserung – statistisch signifikant.“
Der normale Leser hört wahrscheinlich:
Das Produkt wirkt statistisch signifikant.
Nur wurde das gar nicht gezeigt.
Gezeigt wurde etwas anderes.
Die Forschungsfrage wurde verändert.
Und genau das ist für mich eine der interessantesten Formen von statistischem Framing.
Man muss keine Daten fälschen.
Manchmal reicht es völlig, die richtige – oder besser gesagt: die günstigste – Frage zu stellen.
Deshalb frage ich inzwischen anders
Wenn mir jemand sagt:
„Die Studie war signifikant“,
interessiert mich mittlerweile zuerst:
Was war signifikant?
War es der vorher festgelegte primäre Endpunkt?
Oder irgendeine Untergruppe?
Wurde genau diese Analyse vorher geplant?
Oder hat man nachher so lange in den Daten gesucht, bis irgendwo ein schöner p-Wert auftauchte?
Wie groß war der Effekt überhaupt?
Und wie sahen die einzelnen Teilnehmer aus?
Denn unsere kleine Supplement-Studie kann man problemlos so zusammenfassen:
Mehr Menschen verschlechterten sich als verbesserten sich.
Oder so:
75 Prozent blieben stabil oder verbesserten sich.
Oder:
High-Responder erreichten Verbesserungen von bis zu 60 Prozent.
Alle drei Aussagen können stimmen.
Und erzählen trotzdem drei völlig unterschiedliche Geschichten.
Darum geht es mir.
Nicht darum, Studien schlechtzureden.
Sondern darum, etwas genauer hinzuschauen.
Denn vielleicht ist bei einer Studie nicht nur die Frage interessant:
„Was ist das Ergebnis?“
Sondern mindestens genauso:
„Wie sind wir eigentlich genau zu diesem Ergebnis gekommen?“
FAQ
Was bedeutet statistische Signifikanz?
Statistische Signifikanz beschreibt vereinfacht, wie gut die beobachteten Daten mit einer vorher definierten Nullhypothese vereinbar sind. Sie sagt nicht automatisch, dass ein Effekt groß, medizinisch relevant oder kausal ist.
Was bedeutet ein p-Wert unter 0,05?
Er bedeutet nicht, dass die Wahrscheinlichkeit, dass das Ergebnis Zufall ist, unter fünf Prozent liegt. Der p-Wert beschreibt die Wahrscheinlichkeit, unter der Nullhypothese Daten zu beobachten, die mindestens so extrem sind wie die gemessenen.
Kann man mit denselben Studiendaten unterschiedliche Ergebnisse erhalten?
Ja. Unterschiedliche Endpunkte, statistische Modelle, Subgruppen oder Definitionen können zu unterschiedlichen Resultaten führen. Deshalb sind vorab festgelegte Hypothesen und Analysen so wichtig.
Was ist p-Hacking?
Von p-Hacking spricht man, wenn viele Analysen, Gruppen oder Endpunkte ausprobiert werden und anschließend vor allem diejenigen Ergebnisse berichtet werden, die statistisch signifikant sind.


